SCT

กำลังเตรียมประสบการณ์ดิจิทัล

บทความคลาวด์

วิธีออกแบบ ย้าย และควบคุมค่าใช้จ่ายระบบบนคลาวด์ รวมถึงเทคนิคจากผู้ให้บริการรายใหญ่ ที่ทีมงานสรุปให้เหมาะกับขนาดธุรกิจไทย

คลังบทความ

บทความหมวด คลาวด์

ทั้งหมด 18 บทความ · หมวด คลาวด์ · อัปเดตล่าสุด 16 พฤศจิกายน 2569

เปลี่ยนค่า DNS แล้วมีผลเร็วขึ้นเท่าตัว: Cloudflare เลิกสร้างข้อมูลโซนใหม่ทั้งก้อน ใช้ targeted build ลดหน่วยความจำ 85% คลาวด์

เปลี่ยนค่า DNS แล้วมีผลเร็วขึ้นเท่าตัว: Cloudflare เลิกสร้างข้อมูลโซนใหม่ทั้งก้อน ใช้ targeted build ลดหน่วยความจำ 85%

เมื่อแก้ระเบียน DNS หรือเปิดฟีเจอร์ของโดเมน ทุกวินาทีที่รอให้ค่าใหม่มีผลคือช่วงที่เว็บอาจชี้ไปผิดที่ Cloudflare ลดเวลานี้ (ค่ามัธยฐาน) จากราว 7.7 วินาทีเหลือ 3.3 วินาที ลดช่วงช้าที่สุดจาก 14.6 นาทีเหลือ 1.2 นาที และลดหน่วยความจำของระบบลง 85% ด้วยหลักคิดเดียว คือสร้างใหม่เฉพาะส่วนที่เปลี่ยน แทนการสร้างข้อมูลทั้งโซนใหม่ทุกครั้ง บทความนี้สรุปว่าออกแบบอย่างไรให้เร็วขึ้นโดยข้อมูลไม่ผิด

อ่านบทความ
อินเทอร์เน็ตล่ม 49 ครั้งในไตรมาสเดียว: บทเรียนจากรายงาน Cloudflare Radar ว่าไฟดับ แผ่นดินไหว และศูนย์ข้อมูลขัดข้องทำให้เว็บล่มอย่างไร และธุรกิจควรเตรียมอะไร คลาวด์

อินเทอร์เน็ตล่ม 49 ครั้งในไตรมาสเดียว: บทเรียนจากรายงาน Cloudflare Radar ว่าไฟดับ แผ่นดินไหว และศูนย์ข้อมูลขัดข้องทำให้เว็บล่มอย่างไร และธุรกิจควรเตรียมอะไร

เว็บไซต์หรือแอปที่ใช้งานไม่ได้ไม่ได้เกิดจากโค้ดเสมอไป บางครั้งต้นเหตุอยู่ไกลถึงโรงไฟฟ้า สายเคเบิลใต้ดิน หรือระบบทำความเย็นของศูนย์ข้อมูล Cloudflare Radar สรุปว่าในไตรมาส 3 ปี 2026 มีเหตุการณ์อินเทอร์เน็ตขัดข้องระดับประเทศหรือระดับผู้ให้บริการรวม 49 ครั้ง บทความนี้แยกให้เห็นว่าเกิดจากอะไรบ้าง และธุรกิจที่มีเว็บหรือแอปควรวางระบบอย่างไรเพื่อไม่ล่มตามไปด้วย

อ่านบทความ
GitHub ย้ายข้อมูล Git เกือบพันล้าน repository ไปไว้บน Azure รับทราฟฟิกยุคเอเจนต์ AI: แนวคิด quorum รายสาขาและการแยกที่เก็บข้อมูลออกจากเครื่องประมวลผล คลาวด์

GitHub ย้ายข้อมูล Git เกือบพันล้าน repository ไปไว้บน Azure รับทราฟฟิกยุคเอเจนต์ AI: แนวคิด quorum รายสาขาและการแยกที่เก็บข้อมูลออกจากเครื่องประมวลผล

เมื่อเอเจนต์ AI เริ่มเขียนและส่งโค้ดแทนคน ทราฟฟิก Git ของ GitHub โตแบบทวีคูณจนใกล้ชนเพดานกำลังไฟของศูนย์ข้อมูลเดิม GitHub เล่าว่าย้ายสำเนาของ repository เกือบทั้งหมดไปไว้บน Azure แล้ว และกำลังเปลี่ยนสถาปัตยกรรมให้รับงานเขียนได้มากขึ้น 3-4 เท่า บทความนี้สรุปแนวคิดหลักที่ทีมพัฒนาระบบทั่วไปนำไปใช้ได้ ตั้งแต่ลำดับการย้ายระบบที่ลดความเสี่ยง ไปจนถึงการลดงานที่ต้องเข้าคิวรอกันโดยไม่จำเป็น

อ่านบทความ
กรอง จัดรูปแบบ และปิดข้อมูลส่วนบุคคลใน log ก่อนส่งออก: แนวคิดจาก Cloudflare Logpush Transformers ที่ใช้กับระบบ log ใดก็ได้ คลาวด์

กรอง จัดรูปแบบ และปิดข้อมูลส่วนบุคคลใน log ก่อนส่งออก: แนวคิดจาก Cloudflare Logpush Transformers ที่ใช้กับระบบ log ใดก็ได้

log ของเว็บไซต์มักถูกส่งต่อไปยังระบบวิเคราะห์ ระบบความปลอดภัย หรือที่เก็บข้อมูลระยะยาวทั้งก้อน ทั้งที่ส่วนหนึ่งไม่มีใครใช้ และบางฟิลด์เป็นข้อมูลส่วนบุคคลอย่างหมายเลข IP Cloudflare เปิดให้ใช้ Logpush Transformers ซึ่งให้เขียน SQL สั้น ๆ กรอง จัดรูปแบบ และปิดข้อมูลก่อน log ออกจากระบบ ใช้ได้ทุกแพ็กเกจรวมแผนฟรี บทความนี้อธิบายวิธีคิดเบื้องหลัง ซึ่งนำไปใช้กับระบบ log ใดก็ได้

อ่านบทความ
กุญแจรากของ DNS เปลี่ยน 11 ตุลาคม 2569: องค์กรที่ตั้ง DNS resolver เองต้องตรวจอะไร และทดสอบด้วยคำสั่งเดียวว่าพร้อมหรือยัง คลาวด์

กุญแจรากของ DNS เปลี่ยน 11 ตุลาคม 2569: องค์กรที่ตั้ง DNS resolver เองต้องตรวจอะไร และทดสอบด้วยคำสั่งเดียวว่าพร้อมหรือยัง

วันที่ 11 ตุลาคม 2569 กุญแจที่ใช้ลงลายเซ็นรากของระบบ DNS จะเปลี่ยนจากชุดเดิม KSK-2017 เป็นชุดใหม่ KSK-2024 คนทั่วไปและเจ้าของเว็บส่วนใหญ่ไม่ต้องทำอะไร แต่องค์กรที่ตั้งเครื่อง DNS resolver ของตัวเองและเปิดตรวจ DNSSEC ไว้ ถ้าเครื่องยังไม่รู้จักกุญแจใหม่ ผู้ใช้ในองค์กรอาจเปิดเว็บแทบไม่ได้เลยตั้งแต่วันนั้น บทความนี้อธิบายว่ากุญแจนี้ทำหน้าที่อะไร ใครต้องตรวจ และวิธีทดสอบที่ใช้เวลาไม่ถึงนาที

อ่านบทความ
Cloudflare ประหยัด RAM 100 TB ด้วยคณิตศาสตร์และ Rust: ลดจุดแฮชใน consistent hashing ลง 90% โดยการกระจายโหลดแทบไม่เปลี่ยน คลาวด์

Cloudflare ประหยัด RAM 100 TB ด้วยคณิตศาสตร์และ Rust: ลดจุดแฮชใน consistent hashing ลง 90% โดยการกระจายโหลดแทบไม่เปลี่ยน

Cloudflare ลดหน่วยความจำของบริการกระจายโหลดภายในลงรวม 100 TB ทั่วโลก จากการตั้งคำถามกับค่าตั้งต้นที่ทุกคนใช้กันมาหลายปี คือจำนวนจุดแฮชต่อเซิร์ฟเวอร์ใน consistent hashing การคำนวณพบว่าจุดแฮช 90,000 จุดสุดท้ายต่อเซิร์ฟเวอร์ช่วยให้โหลดกระจายสม่ำเสมอขึ้นเพียง 0.7% และเมื่อเกินราว 10,000 จุด การชนกันของค่าแฮชกลับทำให้แย่ลง ทีมจึงลดจุดแฮชลง 90% และบีบขนาดโครงสร้างข้อมูลใน Rust อีก 25% บทความนี้อธิบายคณิตศาสตร์เบื้องหลัง วิธีบีบข้อมูลโดยไม่ใช้ unsafe และวิธีปล่อยการเปลี่ยนแปลงที่เสี่ยงโดยไม่ทำให้แคชทั้งโลกหาย

อ่านบทความ
ย้ายงานอัตโนมัติเมื่อเซิร์ฟเวอร์ล่มด้วย lease บน DynamoDB: ออกแบบ WebSocket worker ที่ไม่ทำข้อมูลหาย คลาวด์

ย้ายงานอัตโนมัติเมื่อเซิร์ฟเวอร์ล่มด้วย lease บน DynamoDB: ออกแบบ WebSocket worker ที่ไม่ทำข้อมูลหาย

ระบบเรียลไทม์ที่ต้องเปิดการเชื่อมต่อค้างไว้นาน ๆ เสี่ยงทำข้อมูลหายทุกครั้งที่เซิร์ฟเวอร์ล่มหรือมีการ deploy ตัวอย่างจาก AWS คือบริการถอดเสียงประชุม 500 ห้องพร้อมกัน ที่ worker ตัวเดียวล่มแล้วการเชื่อมต่อหลุดกว่า 100 รายการ และแต่ละรายการขาดข้อมูล 2-3 นาทีจนกว่าจะมีคนมารีสตาร์ต บทความนี้สรุปแนวทางให้ worker ตัวอื่นรับงานต่อเองด้วย lease บน DynamoDB ทั้งโครงสร้างข้อมูล ลำดับเหตุการณ์ ค่าที่ควรตั้ง ค่าใช้จ่าย และจุดที่ต้องคิดเพิ่ม

อ่านบทความ
ทดสอบว่าระบบคิวพังอย่างไรก่อนของจริงพัง: ใช้ AWS Fault Injection Service ตัดสิทธิ์ SQS เป็นช่วง ๆ แล้ววัดผล คลาวด์

ทดสอบว่าระบบคิวพังอย่างไรก่อนของจริงพัง: ใช้ AWS Fault Injection Service ตัดสิทธิ์ SQS เป็นช่วง ๆ แล้ววัดผล

กลไกกันพังที่ไม่เคยถูกทดสอบเป็นแค่สมมติฐาน ระบบที่พึ่งคิวข้อความจะรู้ว่ารอดหรือไม่ก็ต่อเมื่อคิวใช้ไม่ได้จริง AWS Architecture Blog เสนอวิธีจำลองเหตุนั้นอย่างปลอดภัยและทำซ้ำได้ ด้วยการใช้ AWS Fault Injection Service ตัดสิทธิ์เข้าถึงคิว Amazon SQS เป็นช่วงที่ยาวขึ้นเรื่อย ๆ บทความนี้เรียบเรียงสิ่งที่ต้องเตรียม วิธีอ่านผลฝั่งผู้ส่งและผู้รับ และกับดักที่อาจทำให้คิวถูกล็อกจนกู้เองไม่ได้

อ่านบทความ
จัดการดาต้าเซ็นเตอร์หลายแห่งจากศูนย์กลางเดียว: สถาปัตยกรรม hybrid cloud orchestration แบบ event-driven บน AWS คลาวด์

จัดการดาต้าเซ็นเตอร์หลายแห่งจากศูนย์กลางเดียว: สถาปัตยกรรม hybrid cloud orchestration แบบ event-driven บน AWS

องค์กรที่มีดาต้าเซ็นเตอร์หรือไซต์กระจายหลายแห่งมักเจอปัญหาเดียวกัน ขั้นตอนต่างกันตามฮาร์ดแวร์แต่ละยี่ห้อ งานดูแลวงจรชีวิตเซิร์ฟเวอร์ต้องทำมือ มองเห็นสถานะไม่ทั่ว และเครื่องมือเดิมขยายไม่ไหวเมื่อมีเครื่องนับพันในหลายร้อยไซต์ บทความจาก AWS Architecture Blog เสนอเครื่องยนต์ orchestration แบบ event-driven ที่ใช้บริการ serverless บน AWS ควบคุมคลัสเตอร์ EKS Anywhere และฮาร์ดแวร์ในไซต์ผ่าน Redfish API บทความนี้สรุปสถาปัตยกรรม ลำดับการทำงาน และข้อพิจารณาสำหรับองค์กรไทยที่ยังต้องเก็บระบบบางส่วนไว้ในประเทศ

อ่านบทความ
แลกซีพียูเล็กน้อยกับพื้นที่แคชระดับเพตะไบต์: บทเรียนการบีบอัดข้อมูลที่ชั้นแคช คลาวด์

แลกซีพียูเล็กน้อยกับพื้นที่แคชระดับเพตะไบต์: บทเรียนการบีบอัดข้อมูลที่ชั้นแคช

ราคาหน่วยความจำและดิสก์แพงขึ้นต่อเนื่อง การบีบอัดข้อมูลที่ชั้นแคชจึงกลับมาเป็นทางเลือกที่คุ้ม บทความนี้สรุปการทดลองบีบอัดเนื้อหาด้วย Zstandard ที่ได้พื้นที่คืนราวสองในสาม โดยแลกกับซีพียูเพียงไม่กี่เปอร์เซ็นต์

อ่านบทความ
ลดหน่วยความจำได้ 100 เทระไบต์ด้วยการจัดโครงสร้างข้อมูลใหม่: บทเรียนจากแคช DNS ระดับโลก คลาวด์

ลดหน่วยความจำได้ 100 เทระไบต์ด้วยการจัดโครงสร้างข้อมูลใหม่: บทเรียนจากแคช DNS ระดับโลก

ในระบบที่เก็บข้อมูลหลายแสนล้านชิ้น ไบต์เดียวที่เปลืองต่อชิ้นก็กลายเป็นหน่วยความจำหลายร้อยกิกะไบต์ Cloudflare ปรับวิธีเก็บแคชของบริการ DNS อย่าง 1.1.1.1 ห้ารอบ ลดหน่วยความจำต่อรายการได้กว่าครึ่ง คืนหน่วยความจำทั้งระบบราว 100 เทระไบต์ และแคชยังเร็วขึ้นด้วย บทความนี้จัดกลุ่มการเปลี่ยนแปลงตามหลักคิด ซึ่งทีมไทยนำไปใช้กับแคชหรือคิวงานของตัวเองได้แม้สเกลจะเล็กกว่ามาก

อ่านบทความ
กันเส้นทางอินเทอร์เน็ตรั่วด้วย BGP Roles: มาตรฐาน RFC 9234 คืออะไรและใครใช้แล้วบ้าง คลาวด์

กันเส้นทางอินเทอร์เน็ตรั่วด้วย BGP Roles: มาตรฐาน RFC 9234 คืออะไรและใครใช้แล้วบ้าง

เหตุการณ์ทราฟฟิกอินเทอร์เน็ตวิ่งผิดเส้นทางจนบริการล่มเป็นวงกว้างเกิดขึ้นซ้ำ ๆ มาหลายปี มาตรฐาน RFC 9234 พยายามแก้ที่ต้นเหตุด้วยการให้เราเตอร์ตกลงบทบาทกันตั้งแต่เริ่มเชื่อมต่อ บทความนี้สรุปว่ามันทำงานอย่างไรและการนำไปใช้จริงติดตรงไหน

อ่านบทความ
แอปภายในที่สร้างด้วย AI มักหลุดขึ้นอินเทอร์เน็ตโดยไม่ตั้งใจ: ปิดด้วยนโยบายที่ระดับบัญชี คลาวด์

แอปภายในที่สร้างด้วย AI มักหลุดขึ้นอินเทอร์เน็ตโดยไม่ตั้งใจ: ปิดด้วยนโยบายที่ระดับบัญชี

เมื่อ AI ทำให้พนักงานสร้างและดีพลอยแอปขึ้นอินเทอร์เน็ตได้ในเวลาไม่กี่นาที ความเสี่ยงใหม่คือเครื่องมือภายในและข้อมูลบริษัทหลุดออกไปโดยไม่มีใครตั้งใจ บทความนี้สรุปแนวคิดการทำให้ "ต้องล็อกอินก่อน" เป็นค่าเริ่มต้นของทุกแอป แทนที่จะฝากไว้กับความจำของนักพัฒนาแต่ละคน

อ่านบทความ
ทบทวนการโจมตี Spectre ระยะไกลบน Cloudflare Workers: บทเรียนการแยกผู้เช่าบนคลาวด์ คลาวด์

ทบทวนการโจมตี Spectre ระยะไกลบน Cloudflare Workers: บทเรียนการแยกผู้เช่าบนคลาวด์

ทีมวิจัยกลับมาทดสอบการโจมตี Spectre บนแพลตฟอร์ม Workers อีกครั้ง แล้วพบว่ายังดึงข้อมูลข้ามผู้เช่าได้ที่อัตราสูงสุด 12 บิตต่อวินาทีด้วยความแม่นยำ 99% บทความนี้สรุปว่าการโจมตีทำได้อย่างไร ทำไมมาตรการเดิมถึงไม่พอ และมาตรการใหม่ที่นำมาใช้บอกอะไรกับทีมที่ออกแบบระบบหลายผู้เช่า

อ่านบทความ
MCP กำลังกลายเป็น Shadow IT ตัวใหม่: มองเห็นและควบคุมทราฟฟิกของ AI Agent คลาวด์

MCP กำลังกลายเป็น Shadow IT ตัวใหม่: มองเห็นและควบคุมทราฟฟิกของ AI Agent

พนักงานเชื่อม AI agent เข้ากับเครื่องมือภายในองค์กรได้ด้วยการตั้งค่าเพียงบรรทัดเดียว ทำให้เกิด Shadow MCP ที่ฝ่ายไอทีมองไม่เห็น บทความนี้สรุปวิธีตรวจจับทราฟฟิก MCP ความเสี่ยงที่ต่างจากผู้ใช้ที่เป็นมนุษย์ และแนวทางไล่จากการมองเห็นไปสู่การกำกับดูแล

อ่านบทความ
ลดค่าใช้จ่ายคลาวด์อย่างเป็นระบบตามแนวทาง AWS Well-Architected คลาวด์

ลดค่าใช้จ่ายคลาวด์อย่างเป็นระบบตามแนวทาง AWS Well-Architected

องค์กรจำนวนมากจ่ายค่าคลาวด์เกินจำเป็น 20-30% จากทรัพยากรที่ไม่ได้ใช้และขนาดที่ใหญ่เกินงาน บทความนี้สรุปหลักการจาก Cost Optimization Pillar ของ AWS Well-Architected Framework ตั้งแต่การมองเห็นค่าใช้จ่าย การเลือกโมเดลราคา ไปจนถึงการสร้างวัฒนธรรม FinOps ในทีม

อ่านบทความ
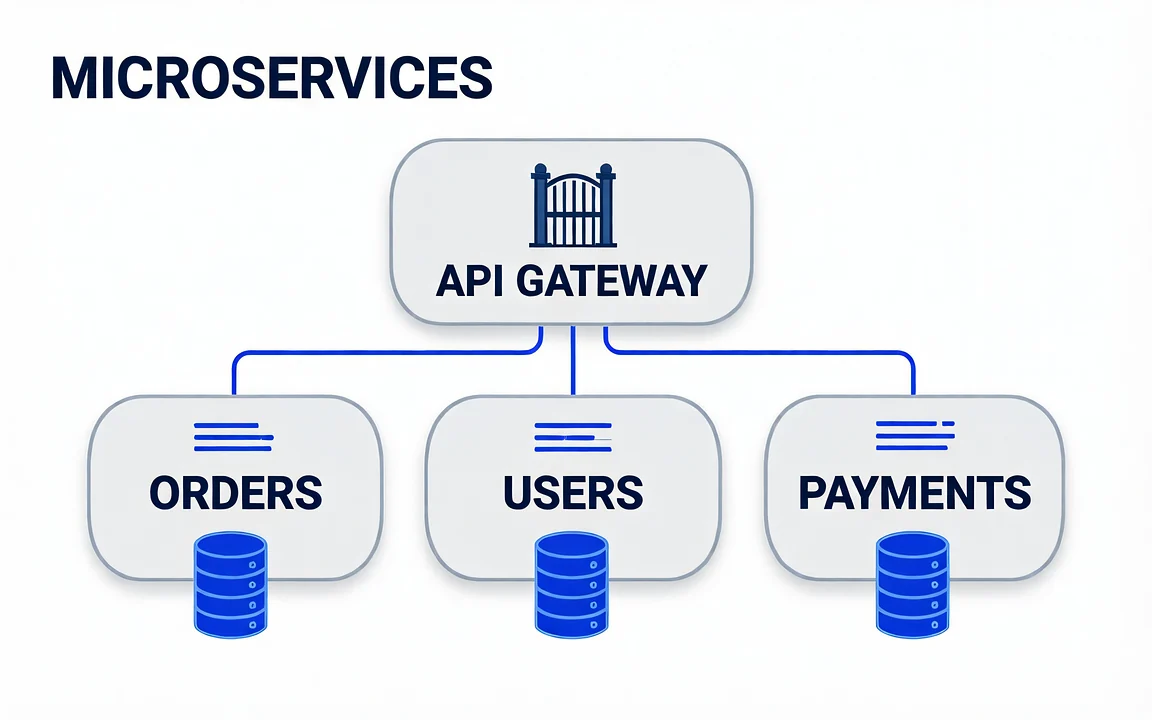
Microservices ตามแนวคิด Martin Fowler: เมื่อไรควรใช้ และแพตเทิร์นที่ต้องรู้ คลาวด์

Microservices ตามแนวคิด Martin Fowler: เมื่อไรควรใช้ และแพตเทิร์นที่ต้องรู้

Microservices ไม่ใช่คำตอบของทุกระบบ Martin Fowler เตือนไว้ชัดเจนว่าอย่าเริ่มโปรเจกต์ใหม่ด้วย Microservices ทันที บทความนี้อธิบายว่าสถาปัตยกรรมนี้คืออะไร เหมาะกับใคร พร้อมแพตเทิร์นสำคัญอย่าง API Gateway, Database per Service และ Circuit Breaker

อ่านบทความ
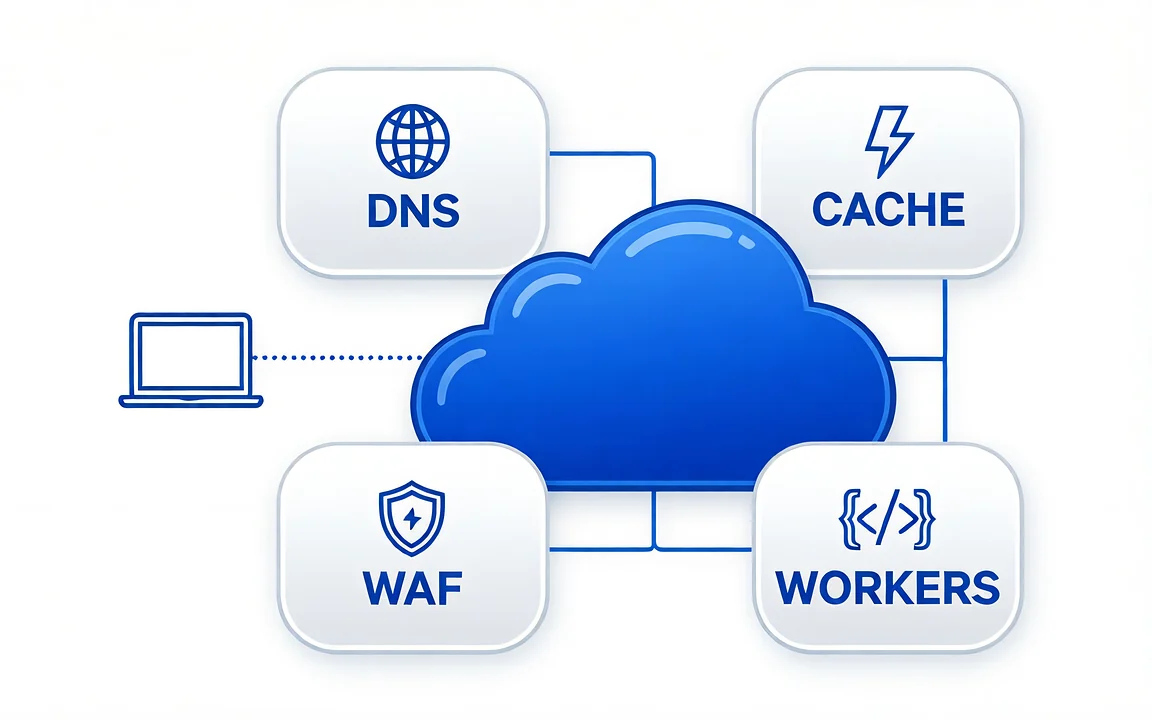
Cloudflare ฉบับเริ่มต้น: เข้าใจ DNS, Cache, WAF และ Workers ใน 10 นาที คลาวด์

Cloudflare ฉบับเริ่มต้น: เข้าใจ DNS, Cache, WAF และ Workers ใน 10 นาที

Cloudflare กลายเป็นชั้นหน้าบ้านของเว็บจำนวนมากทั่วโลก แต่เมนูตั้งค่าหลายร้อยรายการทำให้ผู้เริ่มต้นถอดใจ บทความนี้สรุปแนวคิดหลักจากเอกสารทางการของ Cloudflare อธิบาย DNS, Proxy, Cache, WAF และ Workers ด้วยภาษาที่เข้าใจง่าย พร้อมคำแนะนำว่าเว็บแบบไหนควรใช้หรือยังไม่จำเป็น

อ่านบทความ

ทำไมต้องอ่านจากแหล่งอ้างอิง

แนวทางการจัดทำเนื้อหา

ทุกบทความระบุแหล่งอ้างอิงต้นทางไว้เสมอ คุณจึงตรวจสอบและอ่านต่อจากต้นฉบับได้ด้วยตัวเอง

นักเขียนเนื้อหาเทคนิคเปิดอ่านหนังสืออ้างอิงเล่มหนาที่โต๊ะทำงาน

อ้างอิงจากมาตรฐานสากล

เนื้อหาอิงจากเอกสารของ OWASP, NIST, Google, AWS และแหล่งอ้างอิงที่วงการยอมรับ

จอคอมพิวเตอร์แสดงหน้าบทความที่จัดวางตัวอักษรอ่านง่าย

เรียบเรียงเป็นภาษาไทย

แปลงศัพท์เทคนิคเป็นภาษาที่เจ้าของธุรกิจอ่านแล้วตัดสินใจได้

เจ้าของธุรกิจอ่านบทความบนแท็บเล็ตพร้อมสมุดจดบันทึกข้างตัว

นำไปประยุกต์ใช้ได้จริง

ทุกบทความมีสิ่งที่ควรจำและขั้นตอนที่ลงมือทำต่อได้ทันที

ติดต่อเพื่อขอรับคำปรึกษา

อ่านแล้วเห็นภาพว่าต้องทำอะไร แต่ยังไม่มีทีมลงมือ? เราช่วยได้ตั้งแต่ให้คำปรึกษาจนถึงพัฒนาให้ครบวงจร

ปรึกษาทีมของเรา