9 กันยายน 2569
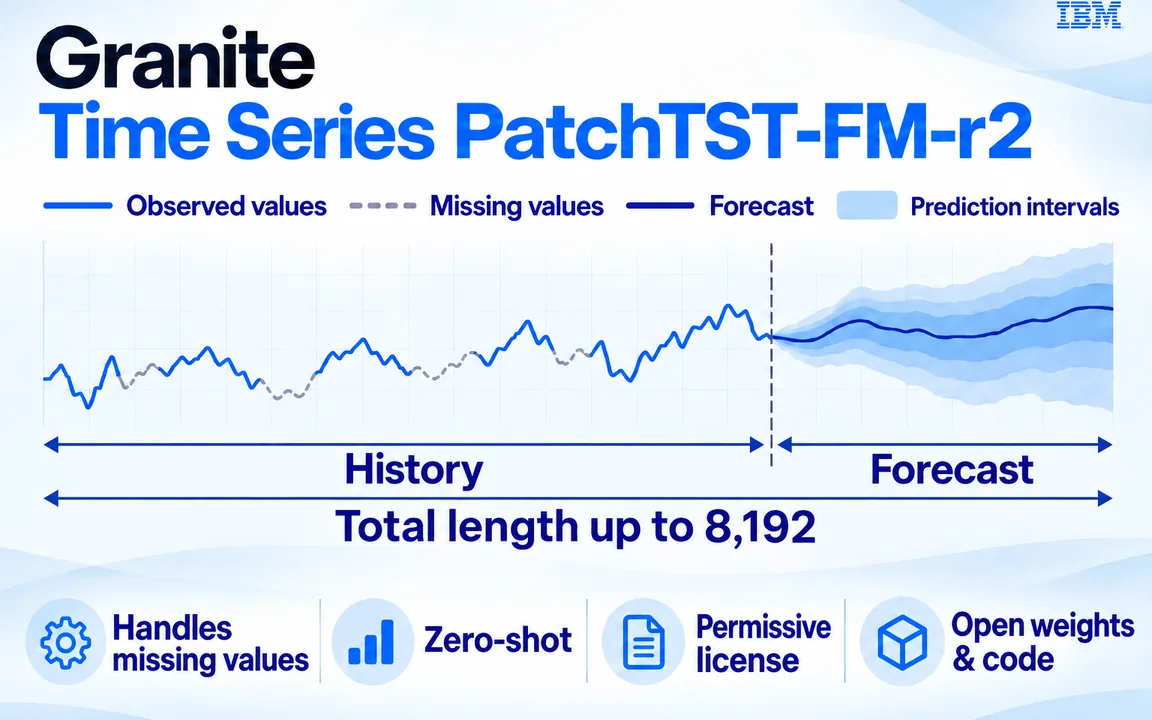
IBM ปล่อยโมเดลพื้นฐานสำหรับพยากรณ์อนุกรมเวลาชื่อ Granite Time Series PatchTST-FM-r2 ขนาดราว 385 ล้านพารามิเตอร์ จุดเด่นคือพยากรณ์ได้ทันทีโดยไม่ต้องเทรนเพิ่มกับข้อมูลของแต่ละงาน และให้สัญญาอนุญาตแบบเลือกได้ระหว่าง Apache 2.0 กับ OpenMDW 1.0 ซึ่งใช้เชิงพาณิชย์ได้ บนกระดานวัดผล GIFT-Eval โมเดลนี้อยู่อันดับหนึ่งในกลุ่มโมเดลที่ใช้เชิงพาณิชย์ได้และทำนายแบบไม่ต้องเทรนเพิ่ม
อนุกรมเวลาคือข้อมูลที่เรียงตามเวลา เช่น ยอดขายรายวัน ปริมาณการใช้ไฟฟ้ารายชั่วโมง หรือจำนวนคำขอที่เข้าระบบรายนาที การพยากรณ์ข้อมูลกลุ่มนี้เดิมต้องสร้างโมเดลแยกต่อหนึ่งงาน ซึ่งกินเวลาและต้องมีคนที่เข้าใจสถิติมาดูแล แนวคิดของโมเดลพื้นฐานคือเทรนครั้งเดียวกับข้อมูลจำนวนมาก แล้วนำไปใช้กับงานใหม่ได้เลยโดยไม่ต้องเทรนเพิ่ม
PatchTST-FM-r2 เป็นรุ่นต่อจาก r1 โดยขยายจำนวนบล็อกจาก 20 เป็น 30 บล็อก ใช้โครงสร้างแบบ conformer ที่ผสมกลไก multi-head self-attention เข้ากับการคำนวณแบบ convolution ตามแกนเวลา เพื่อให้จับได้ทั้งความสัมพันธ์ระยะไกลและรูปแบบระยะสั้น รับข้อมูลย้อนหลังได้สูงสุด 8,192 จุด และให้ผลพยากรณ์เป็น 99 ควอนไทล์ ซึ่งหมายความว่าได้ช่วงความไม่แน่นอนมาด้วย ไม่ใช่แค่ตัวเลขเดียว
ด้านผลวัด ณ วันที่ 8 กันยายน 2026 บนกระดาน GIFT-Eval โมเดลนี้อยู่อันดับ 2 ในกลุ่มโมเดลที่ทำนายได้ทันทีและทำซ้ำผลได้ และอยู่อันดับ 1 ในกลุ่มที่ใช้เชิงพาณิชย์ได้ ค่า CRPS เฉลี่ยเรขาคณิตอยู่ที่ 0.467 และค่า MASE อยู่ที่ 0.6846 IBM ระบุว่าโมเดลทำได้ดีกว่า Chronos-2, Timer-S1 และ Toto หลายรุ่น ทั้งที่บางตัวมีขนาดใหญ่กว่ามาก
จุดที่ควรสังเกตคือชุดข้อมูลที่ใช้เทรนถูกระบุไว้ชัดเจนสี่แหล่ง และตัดชุดทดสอบของ GIFT-Eval ออกอย่างชัดแจ้งเพื่อเลี่ยงปัญหาข้อมูลทดสอบรั่วเข้าไปในชุดเทรน ซึ่งเป็นข้อครหาที่พบบ่อยกับโมเดลพยากรณ์ที่อ้างผลสูง การประกาศเรื่องนี้ตรง ๆ ทำให้เทียบผลได้อย่างมีความหมายมากขึ้น
การใช้งานทำผ่านไลบรารี granite-tsfm ตั้งแต่รุ่น 0.3.9 ขึ้นไป ติดตั้งด้วย pip แล้วเรียกโมเดลผ่านคลาส PatchTSTFMForPrediction กับ TimeSeriesForecastingPipeline โดยกำหนดความยาวข้อมูลย้อนหลัง ความยาวช่วงพยากรณ์ และระดับควอนไทล์ที่ต้องการ แล้วส่งข้อมูลเข้าไปได้เลยโดยไม่ต้องเทรนหรือปรับพารามิเตอร์ก่อน IBM ระบุกรณีใช้งานไว้ เช่น การพยากรณ์ความต้องการสินค้า ราคา ปริมาณการใช้พลังงาน ปริมาณการจราจร และข้อมูลวัดจากอุปกรณ์
สำหรับธุรกิจไทย ประโยชน์ที่จับต้องได้ที่สุดคืองานพยากรณ์ที่เคยต้องจ้างผู้เชี่ยวชาญเฉพาะทาง เช่น การคาดการณ์ยอดขายเพื่อวางแผนสต๊อก หรือการคาดการณ์ปริมาณงานเพื่อจัดกำลังคน ตอนนี้เริ่มต้นได้ด้วยข้อมูลที่มีอยู่แล้วโดยไม่ต้องลงทุนเทรนโมเดล และสัญญาอนุญาตที่ใช้เชิงพาณิชย์ได้ทำให้นำไปใช้ในผลิตภัณฑ์จริงได้ ทีมงาน Smart Cyber Tech รับพัฒนาซอฟต์แวร์สั่งทำและระบบ AI รวมถึงต่อยอดโมเดลพยากรณ์เข้ากับระบบหลังบ้านที่ใช้อยู่ ปรึกษาได้ที่ แบบฟอร์มติดต่อ
แหล่งข่าว เรียบเรียงจาก Hugging Face Blog —
อ่านต้นฉบับ ภาพปก: Hugging Face Blog · ลิขสิทธิ์ภาพเป็นของเจ้าของต้นฉบับ ใช้ประกอบการรายงานพร้อมอ้างอิงแหล่งที่มา
เนื้อหาบนหน้านี้เป็นการสรุปและเรียบเรียงเพื่อผู้อ่านชาวไทย หากพบข้อผิดพลาดโปรดแจ้งที่
info@smart-cyber-tech.com บริการที่เกี่ยวข้องจากทีมงาน Smart Cyber Tech แบ่งปันข่าวนี้:
คัดลอกลิงก์ ปรึกษาทีมของเรา