อ่านประมาณ 8 นาที
ระดับกลาง
หมวด: เว็บ
อ้างอิง: Cloudflare Blog — Say it once: introducing Bot Preference Sync
เว็บส่วนใหญ่มีนโยบายบอทอยู่สองที่ที่ไม่ตรงกัน คือสิ่งที่เขียนไว้ใน robots.txt กับกฎที่บังคับใช้จริงหน้าเว็บ บทความนี้อธิบายแนวคิดการซิงก์สองอย่างนี้ให้ตรงกันโดยอัตโนมัติ พร้อมสิ่งที่เจ้าของเว็บไทยควรตัดสินใจในยุคที่บอท AI แยกเป็นหลายประเภท
ปัญหา: สิ่งที่ประกาศไว้กับสิ่งที่บังคับใช้จริงไม่ตรงกัน
เว็บไซต์จำนวนมากมีชั้นจัดการบอทอยู่สองชั้นที่ไม่คุยกัน ชั้นแรกคือไฟล์ robots.txt ซึ่งเป็นการประกาศเจตนาให้บอทที่ให้ความร่วมมืออ่าน ส่วนอีกชั้นคือกฎบล็อกจริงที่ตั้งไว้บนบริการหน้าเว็บ เมื่อสองชั้นนี้ไม่ตรงกัน ผลคือบอทที่ตั้งใจทำตามกฎกลับได้ข้อมูลผิด ขณะที่เจ้าของเว็บเองก็ไม่แน่ใจว่านโยบายที่ใช้จริงคืออะไร
ปัญหานี้หนักขึ้นมากเมื่อบอทไม่ได้มีแค่ประเภทเดียวอีกต่อไป ทุกวันนี้ต้องแยกอย่างน้อยสามกลุ่มคือบอทที่มาเก็บข้อมูลเพื่อทำดัชนีค้นหา บอทที่เป็นผู้ช่วย AI มาดึงหน้าเว็บแทนผู้ใช้ และบอทที่มาเก็บข้อมูลไปฝึกโมเดล ซึ่งเจ้าของเว็บอาจมีท่าทีต่างกันกับแต่ละกลุ่ม
แนวคิดของ Bot Preference Sync
วิธีแก้ที่ Cloudflare เลือกใช้คือสร้างคำสั่งใน robots.txt จากค่าที่ตั้งไว้ในแดชบอร์ดโดยอัตโนมัติ แล้ววางไว้ส่วนหัวของไฟล์เดิม ผลคือสิ่งที่ประกาศออกไปตรงกับสิ่งที่บังคับใช้จริงเสมอ โดยระบบจะอ้างอิงฐานข้อมูลบอทที่อัปเดตต่อเนื่องเพื่อเติมรายชื่อบอทในแต่ละประเภทให้เอง ไม่ต้องมานั่งไล่แก้ชื่อ user-agent ทุกครั้งที่มีบอทตัวใหม่โผล่มา
สำหรับกลุ่มที่ใช้ข้อมูลไปฝึกโมเดลโดยเฉพาะ มีตัวเลือกใหม่ที่เขียนเจตนา "ไม่อนุญาตให้นำไปฝึก" ลงใน robots.txt ซึ่งทำให้บอทที่ให้ความร่วมมือยังเก็บข้อมูลไปทำดัชนีค้นหาได้ตามปกติ แต่ต้องไม่นำไปฝึกโมเดล เป็นการแยกสองเรื่องนี้ออกจากกันอย่างชัดเจนแทนที่จะต้องเลือกบล็อกทั้งหมดหรือปล่อยทั้งหมด
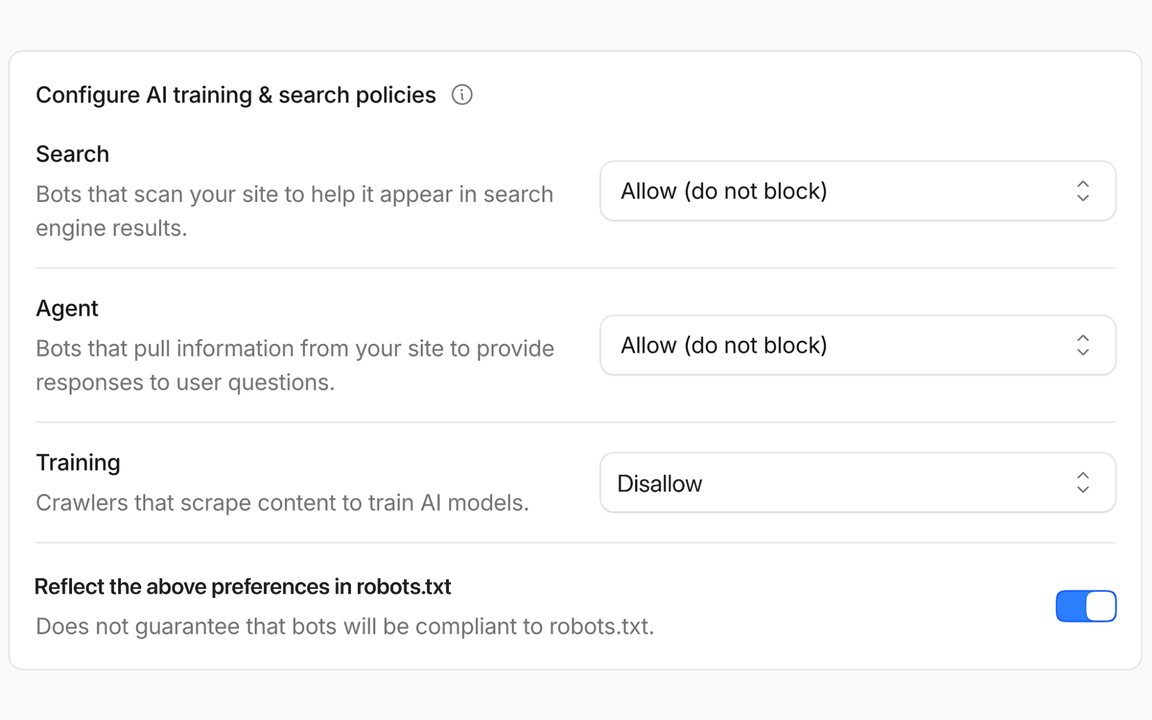 แผนภาพจากบทความต้นฉบับ แสดงการซิงก์นโยบายบอทในแดชบอร์ดเข้าสู่ไฟล์ robots.txt
เงื่อนไขความโปร่งใสของฝั่งบอท
จุดที่น่าสนใจคือบอทที่ทำทั้งงานค้นหาและงานฝึกโมเดลพร้อมกันจะต้องผ่านเงื่อนไขความโปร่งใสก่อน ได้แก่ ต้องเคารพเจตนาไม่ให้ฝึกโมเดล ต้องมีกลไกให้เจ้าของเว็บเลือกไม่เข้าร่วม ต้องบอกได้ว่าเก็บ URL ใดไปบ้าง และต้องแสดงให้เห็นว่าการปฏิเสธการฝึกโมเดลไม่ทำให้อันดับในผลการค้นหาแย่ลง ส่วนบอทที่ไม่โปร่งใสจะถูกบล็อกโดยไม่สนใจว่า robots.txt เขียนอะไรไว้
เงื่อนไขข้อสุดท้ายสำคัญกว่าที่เห็น เพราะข้อกังวลอันดับหนึ่งของเจ้าของเว็บที่ลังเลจะปฏิเสธการฝึกโมเดล คือกลัวว่าจะกระทบการมองเห็นในผลการค้นหาไปด้วย
สิ่งที่เจ้าของเว็บต้องตัดสินใจ
ตัวเลือกสำหรับบอทกลุ่มค้นหาและกลุ่มผู้ช่วย AI มีสามระดับคือ อนุญาต, บล็อกเฉพาะหน้าที่มีโฆษณา และบล็อกทุกหน้า ส่วนกลุ่มฝึกโมเดลมีสองระดับคืออนุญาตหรือไม่อนุญาต สำหรับเว็บที่มีรายได้จากโฆษณาบนหน้าเนื้อหา ค่าเริ่มต้นที่แนะนำคือไม่อนุญาตให้นำไปฝึกโมเดล แต่ยังเปิดให้ทำดัชนีค้นหาตามปกติ
ผู้ที่ต้องการควบคุมละเอียดกว่านั้น เช่น มีข้อตกลงเฉพาะกับผู้ให้บริการบางราย ยังปิดการซิงก์แล้วเขียน robots.txt เองได้ตามเดิม
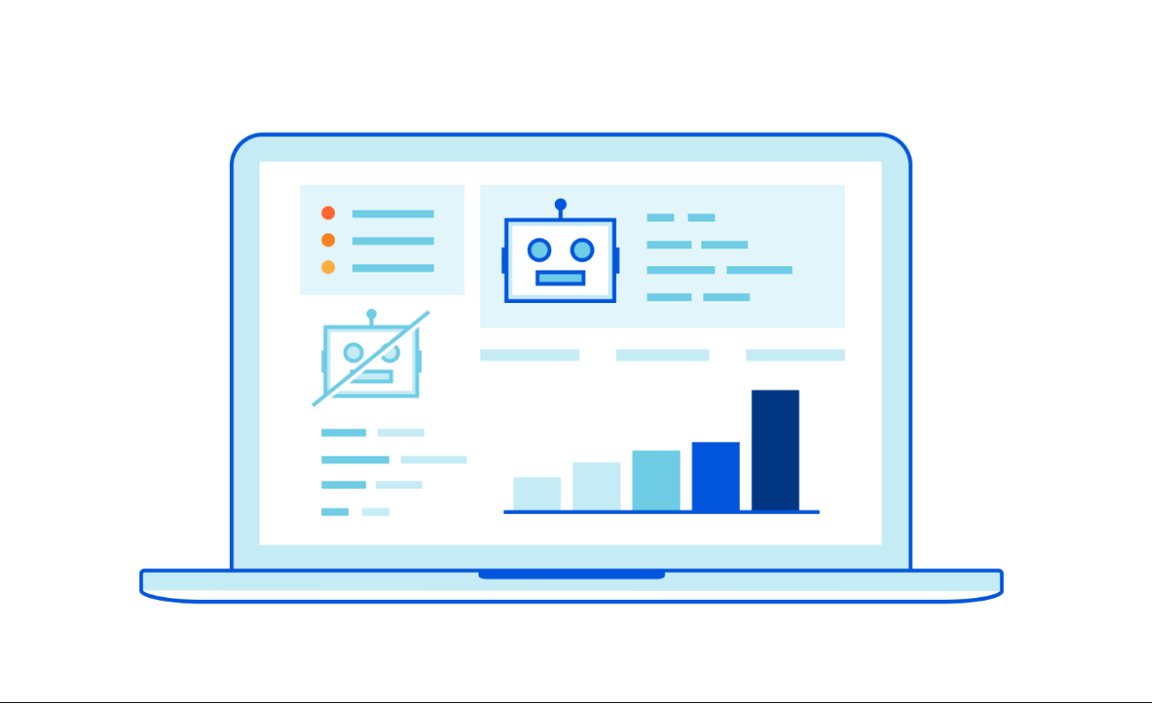 ภาพประกอบจากบทความต้นฉบับ แสดงการแยกประเภทบอทเป็น Search, Agent และ Training
มุมมองสำหรับเว็บไทย
สำหรับเว็บองค์กรทั่วไปที่เนื้อหาเป็นข้อมูลบริการและบทความให้ความรู้ การเปิดให้บอทค้นหาเข้าถึงเต็มที่ยังเป็นทางเลือกที่ถูกต้อง เพราะนั่นคือช่องทางที่ลูกค้าใหม่จะเจอคุณ ส่วนคำถามเรื่องการนำไปฝึกโมเดลควรตัดสินจากลักษณะเนื้อหา ถ้าเป็นงานเขียนต้นฉบับที่ลงทุนผลิตเองและเป็นสินทรัพย์ของธุรกิจ การปฏิเสธการฝึกโมเดลเป็นการรักษาสิทธิ์ที่สมเหตุสมผล
สิ่งที่ควรทำควบคู่คือตรวจสอบว่าไฟล์ robots.txt ปัจจุบันของคุณสอดคล้องกับสิ่งที่ตั้งใจจริงหรือไม่ หลายเว็บยังมีคำสั่งเก่าที่คัดลอกต่อ ๆ กันมาโดยไม่มีใครทบทวน เช่น บล็อกโฟลเดอร์ที่ไม่มีอยู่แล้ว หรือเผลอบล็อกหน้าที่ต้องการให้ติดอันดับ การทบทวนไฟล์นี้เป็นงานที่ใช้เวลาไม่นานแต่ส่งผลต่อการมองเห็นโดยตรง
สรุปสาระสำคัญ
- ปัญหา: สิ่งที่ประกาศไว้กับสิ่งที่บังคับใช้จริงไม่ตรงกัน
- แนวคิดของ Bot Preference Sync
- เงื่อนไขความโปร่งใสของฝั่งบอท
แหล่งอ้างอิงเรียบเรียงจาก Cloudflare Blog — Say it once: introducing Bot Preference Sync —
อ่านบทความต้นฉบับภาพปกและแผนภาพ: Cloudflare Blog · ลิขสิทธิ์ภาพเป็นของเจ้าของต้นฉบับ ใช้ประกอบการรายงานพร้อมอ้างอิงแหล่งที่มา
มีคำถามเพิ่มเติมเกี่ยวกับบทความนี้? เขียนหาเราได้ที่
info@smart-cyber-tech.com
บริการที่เกี่ยวข้องจากทีมงาน Smart Cyber Tech
แบ่งปันบทความนี้:
LINE
Facebook
X
ปรึกษาทีมของเรา