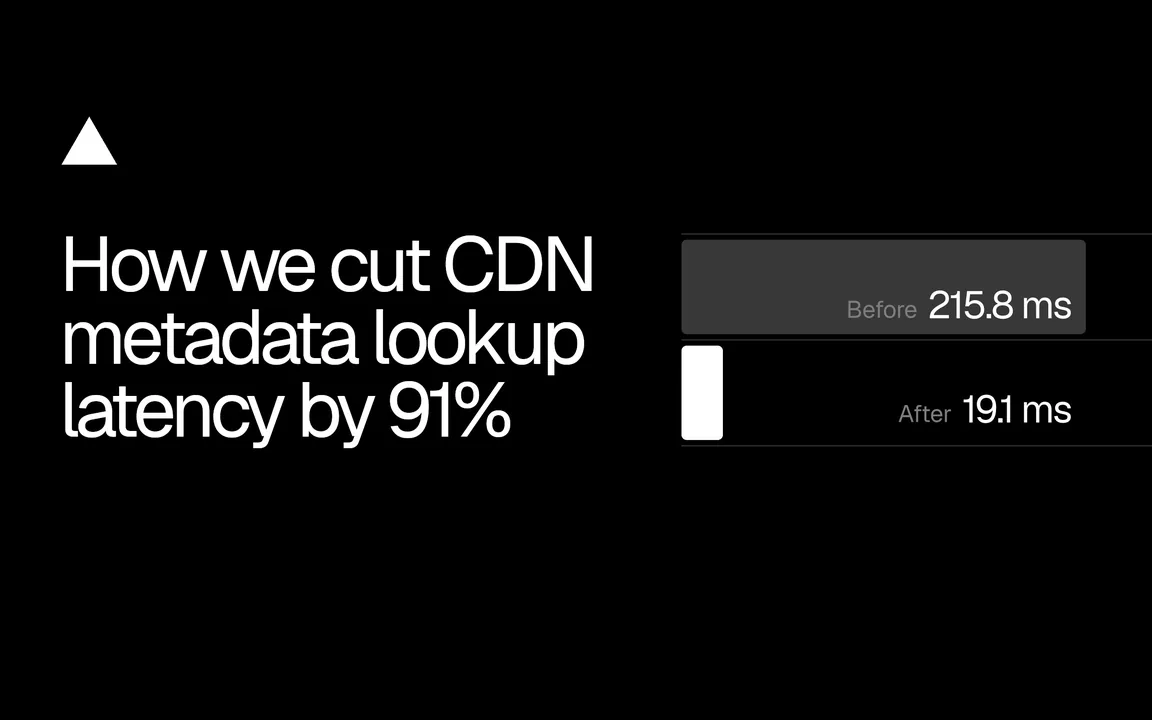
เว็บที่อัปเดตบ่อยมักมีผู้ใช้กลุ่มหนึ่งเจอหน้าโหลดช้าทุกครั้งหลัง deploy ทั้งที่ค่าเฉลี่ยดูปกติ Vercel แก้ปัญหานี้ที่ชั้น CDN จนเวลาค้นหาข้อมูลเส้นทางของคำขอกลุ่มที่ช้าที่สุด 1 เปอร์เซ็นต์ (P99) ลดจาก 215.8 เหลือ 19.1 มิลลิวินาที โดยไม่ได้เพิ่มเครื่อง แต่เปลี่ยนจากการดึงข้อมูลทีละเส้นทางมาเป็นการดึงเป็นก้อนขนาดราว 200 KB ที่มีดัชนีในตัว เราสรุปแนวคิด ตัวเลข และสิ่งที่ทีมพัฒนาเว็บในไทยหยิบไปใช้กับระบบ cache ของตัวเองได้
ปัญหาที่ซ่อนอยู่ใน P99: cache เย็นทุกครั้งที่ deploy
P99 คือเวลาตอบสนองของคำขอกลุ่มที่ช้าที่สุด 1 ใน 100 ตัวเลขนี้มักเผยปัญหาที่ค่าเฉลี่ยกลบไว้ กรณีของ Vercel ปัญหาอยู่ที่ขั้นที่ CDN ต้องรู้ว่าเส้นทางที่ถูกเรียกมีอยู่จริงหรือไม่และต้องเสิร์ฟอย่างไร ข้อมูลส่วนนี้เรียกว่าเมตาดาต้าของเส้นทาง (path metadata) และ CDN ของ Vercel ประมวลผลคำสั่งกำหนดเส้นทางเฉลี่ยกว่า 80 ล้านครั้งต่อวินาที
ระบบเดิมเก็บเมตาดาต้าเป็นอ็อบเจกต์แยกของแต่ละเส้นทาง และ cache แยกกันทีละตัว ซึ่งใช้ได้ดีกับโปรเจกต์เล็กที่ไม่ค่อย deploy แต่โปรเจกต์ใหญ่อาจมีหลายแสนเส้นทาง และการ deploy แต่ละครั้งสร้าง cache key ชุดใหม่ทั้งหมด ใครก็ตามที่เรียกเส้นทางหนึ่งเป็นคนแรกหลังอัปเดตจึงต้องรอ CDN ไปดึงข้อมูลมาก่อน ยิ่งทีม deploy บ่อย ต้นทุนนี้ก็ยิ่งเกิดซ้ำ และไปกองอยู่ที่ปลายหางของกราฟ
งานนี้ซับซ้อนกว่าที่เห็น เพราะ URL ที่ผู้ใช้เรียกไม่ใช่ชื่อไฟล์ที่เสิร์ฟเสมอไป เช่น /blog/hello-world อาจต้องไปจบที่เส้นทางแบบไดนามิก /blog/[slug] ซึ่งเฟรมเวิร์กประกาศไว้ตอน build CDN จึงใช้ Bloom filter (โครงสร้างข้อมูลที่บอกได้เร็วว่าสิ่งใด "ไม่มีแน่นอน") คัดเส้นทางที่ไม่มีจริงทิ้งก่อน แล้วค้นเมตาดาต้าแบบตรงตัวเฉพาะที่เหลือ
แนวคิดหลัก: ดึงทีละกลุ่ม แต่แกะอ่านทีละรายการ
ทางแก้คือรวมเมตาดาต้าของหลายเส้นทางไว้ในไฟล์เดียวที่เรียกว่า shard การดึง shard หนึ่งครั้งจึงอุ่น cache ให้ทุกเส้นทางในไฟล์นั้น คำขอถัด ๆ ไปไม่ต้องเริ่มจากศูนย์ ความท้าทายคือการดึงก้อนใหญ่ต้องไม่ทำให้ต้องแกะข้อมูลทั้งก้อนทุกครั้ง ทีมจึงออกแบบ shard ให้ค้นหาได้ในตัว
ภายใน shard เป็นไฟล์ JSONL (หนึ่งบรรทัดต่อหนึ่งค่า JSON) ที่เรียงเส้นทางกับเมตาดาต้าสลับกันตามลำดับ พร้อมดัชนีบอกตำแหน่งเริ่มของแต่ละรายการเป็นตัวชี้ความยาวคงที่แบบ Base64 ซึ่งถอดค่าทีละตัวได้ทันที เมื่อมีคำขอ ระบบใช้ binary search (ค้นแบบแบ่งครึ่งในข้อมูลที่เรียงแล้ว) ด้วยการอ่านตัวชี้และเทียบสตริงระดับ O(log n) แล้วแปลงเฉพาะค่าของรายการที่ตรงกัน ส่วนอื่นของไฟล์ไม่ถูกแตะ และเพราะข้อมูลชุดแรกของแต่ละ deployment บอกอยู่แล้วว่าเส้นทางใดอยู่ใน shard ไหน จึงไม่ต้องเพิ่มรอบเรียกเครือข่าย
ภาพประกอบบทความหมวดเว็บ ผลลัพธ์ที่วัดจากทราฟฟิกจริง
เวลาค้นหาเมตาดาต้าเส้นทางบน CDN ของ Vercel (ที่มา: Vercel) สิ่งที่วัด ระบบเดิม: แยกทีละเส้นทาง ระบบใหม่: shard มีดัชนี P99 ทั้งแพลตฟอร์ม (ลดลง 91%) 215.8 ms 19.1 ms ค่าเฉลี่ยทั้งแพลตฟอร์ม (ลดลง 79%) 8.59 ms 1.81 ms ส่วนเบี่ยงเบนมาตรฐาน (ลดลง 58%) 44.9 ms 19.0 ms P99 บนเว็บการตลาดและเว็บเอกสารของ Vercel 203 ms 31 ms
ตัวเลขทั้งแพลตฟอร์มวัดช่วง 5-12 สิงหาคม 2026 ส่วนค่ามัธยฐานบนเว็บของ Vercel เองยังอยู่ราว 0.7 มิลลิวินาทีเท่าเดิม แปลว่าแก้ที่ปลายหางโดยไม่ทำให้กรณีปกติช้าลง เมื่อมองทั้งขั้นตอนหาเส้นทาง เว็บขนาดใหญ่มี P99 เร็วขึ้นราวเท่าตัว deployment ที่ build หลัง 17 กรกฎาคม 2026 ได้รูปแบบใหม่แล้ว ส่วนโปรเจกต์เก่าแค่ deploy ใหม่หนึ่งครั้ง โดยเฟรมเวิร์กไม่ต้องแก้อะไร
ขนาด shard: ใหญ่ไปก็ไม่ดี เล็กไปก็ไม่คุ้ม
ช่วงแรกทีมเริ่มที่ shard ขนาดหลายเมกะไบต์ เพราะหวังว่าแต่ละโปรเซสจะเจอข้อมูลใน cache แบบ LRU (เก็บของที่ใช้ล่าสุด ทิ้งของที่ไม่ได้ใช้นานสุด) ในหน่วยความจำของตัวเองแทบทุกครั้ง แต่ผลทดสอบกลับตาลปัตร cache กลางระดับภูมิภาคเจอบ่อยดี ทว่า LRU ของแต่ละโปรเซสเจอน้อย เพราะคำขอกระจายไปหลายโปรเซส และการส่งไฟล์ใหญ่ก็แพงกว่าที่คาด ทีมจึงลดลงมาที่ราว 200 KB ซึ่งยังรักษาอัตราการเจอระดับภูมิภาคไว้ และเติมกลับได้ถูกเมื่อ LRU พลาด
ทีมยังลองบีบ shard ให้เล็กลงด้วยการเข้ารหัสที่กระชับขึ้นสามแบบ เช่น front-coding ที่เก็บเฉพาะส่วนที่ต่างจากเส้นทางก่อนหน้า ผลจำลองชี้ว่าไฟล์เล็กลงมากแต่เวลาค้นหาดีขึ้นไม่เท่าไร จึงพักไว้ก่อนเพราะไม่คุ้มกับงานเปิดใช้
เปลี่ยนระบบที่ทุกคำขอต้องผ่าน โดยไม่ให้ผู้ใช้รู้สึก
ถ้าระบบใหม่ตอบไม่ตรงกับระบบเดิม ผู้ใช้อาจได้เส้นทางเก่า รหัสสถานะผิด หรือ 404 ทั้งที่หน้ามีอยู่ ทีมจึงเทียบผลทุกเส้นทางแบบออฟไลน์ก่อน แล้วเปิด shadow mode บน production คือสุ่มคำขอบางส่วนมาค้นทั้งสองแบบ แต่ตอบผู้ใช้ด้วยผลของระบบเดิม และเทียบผลอยู่เบื้องหลังนานหลายสัปดาห์
ความต่างที่เจอมีน้อยมาก และหนึ่งในนั้นกลับเป็นบั๊กของระบบเดิมที่ห่ออักขระนอก ASCII ด้วยรูปแบบ RFC 2047 แล้วพังเมื่ออีโมจิถูกตัดคร่อมสองท่อน รูปแบบใหม่เก็บเป็น UTF-8 ตรง ๆ บั๊กนี้จึงหายไป ผลพลอยได้อยู่ที่ขั้น build การตัดงานที่ไม่จำเป็นสามอย่าง ซึ่งใหญ่สุดคือการเลิกอัปโหลดเมตาดาต้ารายเส้นทาง (ราว 9.7 วินาที) ประหยัดรวมราว 16.6 วินาที ขั้น deploy เร็วขึ้นราว 10 เปอร์เซ็นต์ และโปรเจกต์ที่มีเมตาดาต้ามากน่าจะใกล้ 25 เปอร์เซ็นต์
บทเรียนที่ทีมพัฒนาเว็บในไทยนำไปใช้ได้
ข้อแรก เฝ้าดู P95 และ P99 ไม่ใช่แค่ค่าเฉลี่ย เพราะปัญหาเชิงโครงสร้างอย่าง cache พลาดหลัง deploy ซ่อนอยู่ที่ปลายหาง ข้อสอง ออกแบบ cache key ให้รอดจากการ deploy เพราะระบบที่อัปเดตบ่อยคือระบบที่ cache เย็นบ่อย ข้อสาม ดึงข้อมูลเป็นก้อนขนาดพอดีมักดีกว่าทีละชิ้น แต่ขนาดที่ดีที่สุดต้องวัดจาก production และข้อสี่ งานที่ทุกคำขอต้องผ่านควรผ่าน shadow mode ก่อนเสมอ
ทีมงาน Smart Cyber Tech รับทำเว็บไซต์และเว็บแอปพลิเคชันด้วย React และ Next.js ที่ออกแบบระบบ cache และวัดประสิทธิภาพจากผู้ใช้จริงตั้งแต่ต้น หากเว็บของคุณเร็วในวันปกติแต่ช้าลงทุกครั้งหลังอัปเดต ปรึกษาได้ที่ แบบฟอร์มติดต่อ
สรุปสาระสำคัญ ปัญหาที่ซ่อนอยู่ใน P99: cache เย็นทุกครั้งที่ deploy แนวคิดหลัก: ดึงทีละกลุ่ม แต่แกะอ่านทีละรายการ ผลลัพธ์ที่วัดจากทราฟฟิกจริง แหล่งอ้างอิง เรียบเรียงจาก Vercel Blog — How we cut CDN metadata lookup latency by 91% —
อ่านบทความต้นฉบับ ภาพปก: Vercel Blog · ลิขสิทธิ์ภาพเป็นของเจ้าของต้นฉบับ ใช้ประกอบการรายงานพร้อมอ้างอิงแหล่งที่มา
มีคำถามเพิ่มเติมเกี่ยวกับบทความนี้? เขียนหาเราได้ที่
info@smart-cyber-tech.com บริการที่เกี่ยวข้องจากทีมงาน Smart Cyber Tech แบ่งปันบทความนี้:
คัดลอกลิงก์ ปรึกษาทีมของเรา